Muchos analistas de negocio nos encontramos inmersos participando en proyectos definiendo iniciativas relacionadas con la automatización digital mediante Inteligencia Artificial y Análisis de Datos Masivos.
Participamos desde la confección del caso de negocio, diseño de soluciones, desarrollo de pruebas de concepto hasta la realización de productos y servicios que impactan en los usuarios y en el entorno.
Es común encontrar desafíos en la arquitectura y la implementación. Estas dificultades son habituales para los profesionales IT, sin embargo, un reto estratégico es el de obtener modelos que mitiguen sesgos no deseados.
¿Dónde podemos encontrar sesgo no deseado en estos sistemas? Imaginemos un escenario en el cual desarrollamos un software que utiliza un modelo de regresión para predecir el precio de viviendas. Al seleccionar los datos para entrenar el modelo recopilamos: ubicación, tamaño, materiales, histórico de precios de compra/venta, variaciones del valor de la propiedad, cercanía a servicios, a zonas verdes, densidad de población, criminalidad, inversiones en infraestructura….
El modelo predictivo podría predecir valores más bajos a viviendas en las cuáles el histórico de precios haya sido bajo, debido a prácticas obsoletas en las cuáles se negaban sistemáticamente servicios financieros a habitantes de cierta zona, debido a situaciones sociales pasadas. Esto implica que el modelo podría asignar precios más bajos a viviendas en vecindarios históricamente afectados por discriminación, sin considerar que esos precios no reflejan el verdadero valor o potencial de las propiedades.
Es crucial identificar estos sesgos que podrían perpetuar prejuicios, pero no se ajustan a la realidad.
Existen técnicas en el ciclo de vida de las aplicaciones de IA, en este caso Modelos de Regresión como: el repesado de los datos (‘re-weigthing’) o la inclusión de restricciones de equidad. Se hace, o bien ajustando los datos de entrenamiento del modelo para mitigar los sesgos estadísticos de características poco representadas, o bien ajustando el modelo eliminando correlaciones no deseadas manteniendo la información relevante para la predicción.
El sesgo no deseado también ocurre en algoritmos de clasificación. Un sistema de reconocimiento facial podría mostrar sesgos debido a una representación demográfica desequilibrada en sus datos de entrenamiento. Al integrar la detección de sesgos durante la recopilación de datos y refinando el modelo, se pueden incluir grupos subrepresentados. Se obtienen así tasas de reconocimiento más justas y acertadas para estas comunidades menos representadas.
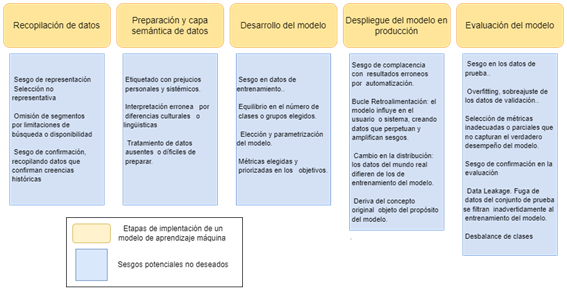
Los analistas de negocio podemos jugar un papel clave al evaluar escenarios y soluciones que contemplen diversos beneficios y cómo estos se pueden ver afectados por decisiones en los datos o en las características de los modelos.
Es crucial poder monitorizar estos beneficios mediante indicadores, ya sean cuantificables o no. Esto permitirá comparar qué cantidad de recursos e inversión será necesaria para avanzar en los desarrollos e ir logrando los resultados esperados.
Los esfuerzos en identificación y preparación de datos se suman a las tareas propias de la implementación de un modelo de predicción o prescripción. Estas soluciones requieren recolección y almacenamiento de datos, parametrización y ajuste de modelos de aprendizaje automático o aprendizaje reforzado, además de las actividades relacionadas con la puesta en producción de software. Estas labores han de ser estimadas y medidas. Su monitorización permite planificar y asignar recursos para lograr los beneficios deseados, mitigando riesgos y detectando rápidamente resultados fallidos, evitando así grandes pérdidas de capital y tiempo.
Los mecanismos para eliminar los sesgos no deseados han de tenerse en consideración a lo largo del ciclo de vida de las aplicaciones. El analista de negocio juega el rol fundamental de entender las implicaciones de diseñar e implementar estas soluciones.
La colaboración entre analistas de negocio y científicos de datos es crucial para lograr productos equitativos. Las técnicas algorítmicas incluyen mecanismos como ajustar las funciones de pérdida, desarrollar algoritmos conscientes de la equidad y utilizar modelos reentrenados que minimicen las distorsiones en los resultados.
Por otro lado, las técnicas de datos se centran en crear conjuntos de datos más inclusivos, equilibrando cuidadosamente la representación de diferentes grupos y etiquetando características de manera responsable y ética. El objetivo principal es asegurar que los sistemas de inteligencia artificial reflejen la diversidad y complejidad del mundo real, reduciendo así los posibles sesgos que puedan surgir durante el entrenamiento y la implementación de los modelos.
Los equipos multidisciplinares y los profesionales con perfiles T (de alta especialización, pero aunando amplios conocimientos organizacionales transversales) permiten construir sistemas más justos, precisos y representativos.
Por ello es vital que se tengan en mente principios definidos por diversos grupos de expertos en marcos como la OCDE o el Grupo de Expertos de Alto Nivel en IA de la Unión Europea y su Guía Ética para una IA Confiable y los definidos estándares ISO:
Equidad: Los sistemas de IA deben evitar estereotipos basados en demografía o cultura.
Fiabilidad y seguridad: Los sistemas de IA deben desarrollarse para evitar causar daño.
Privacidad y seguridad: Proteger los datos y la privacidad del usuario.
Inclusividad: Garantizar que los beneficios de la IA lleguen a todos.
Transparencia: Ser transparentes sobre el funcionamiento de los sistemas de IA.
Si mantenemos estos principios en cada fase, ¡estaremos dando forma a un futuro más equilibrado mediante los servicios y productos que creemos!
Referencias: ISO/IEC (TS) 12791:2024, e ISO ISO/IEC 22989 (Conceptos de IA) y ISO/IEC TR 24028 (Confiabilidad en IA)
Artículo escrito por Ignacio Periquet.
Arquitecto de Datos. Analista de Negocio y Director de Proyectos.
CBAP® CCBA®, ECBA®. PMP®, CAPM®, ITIL v4. Lean IT.
Científico de Inteligencia Artificial: CAIS™.
CBAP® CCBA®, ECBA®. PMP®, CAPM®, ITIL v4. Lean IT.
Científico de Inteligencia Artificial: CAIS™.
VP de Membresía de IIBA® Spain Chapter.